La seguridad de embeddings suele recibir menos atención que los prompts, los documentos o las respuestas de un modelo. Es comprensible: un embedding parece una larga lista de números y no una pieza legible de información.
Esa apariencia puede dar una falsa sensación de anonimización.
El texto original ha desaparecido de nuestra vista, pero la representación vectorial conserva precisamente aquello que necesitamos para trabajar: significado, relaciones semánticas y características útiles para comparar contenidos.
Y si conserva información útil, la pregunta de seguridad es inevitable:
¿Cuánta información puede recuperar un atacante a partir del vector?
NEURON HUMAN
Un embedding no es un hash
Un hash criptográfico está diseñado para que recuperar la entrada original resulte computacionalmente inviable bajo sus supuestos de seguridad.
Un embedding tiene un objetivo completamente diferente: está diseñado para conservar estructura útil.
- similitud semántica;
- contexto;
- relaciones entre conceptos;
- información útil para clasificación o retrieval.
Por eso tratar un vector como “texto irreconstruible” es una suposición insegura.
Embedding inversion: intentar volver del vector al contenido
La investigación sobre embedding inversion intenta reconstruir información original o atributos sensibles a partir de representaciones vectoriales.
En 2026, Zero2Text mostró ataques de inversión de embeddings textuales sin necesidad de disponer de pares filtrados del dominio objetivo, utilizando alineamiento dinámico y conocimiento previo de LLMs.
Otro trabajo de 2026, SPARSE, parte directamente de la premisa de que los ataques de inversión pueden revelar atributos sensibles o reconstruir texto y estudia mecanismos de protección selectiva sobre dimensiones relacionadas con conceptos privados.
La conclusión defensiva no es que cualquier embedding pueda convertirse perfectamente en el texto original con un botón.
La conclusión correcta es que el embedding conserva información suficiente como para que debamos tratarlo como dato potencialmente sensible.
OWASP ya trata vectores y embeddings como superficie de seguridad
OWASP GenAI incluye Vector and Embedding Weaknesses entre los riesgos de aplicaciones LLM.
Entre otros escenarios, señala acceso no autorizado, data leakage, poisoning, problemas de aislamiento multi-tenant e inversión de embeddings.
Esto conecta directamente con nuestro artículo sobre RAG Poisoning: la base vectorial no es únicamente infraestructura de búsqueda. Es parte del plano de datos de seguridad.
El problema multi-tenant
Imagina una plataforma SaaS con miles de documentos de clientes distintos en la misma infraestructura vectorial.
Una consulta semántica no debería poder recuperar vectores o documentos de otro tenant.
OWASP advierte explícitamente de este riesgo: embeddings de un grupo pueden terminar recuperándose en consultas de otro si el aislamiento y los controles de acceso son incorrectos.
La distancia vectorial no conoce tenants.
La similitud semántica no es una frontera de autorización.
NEURON HUMAN
¿Podemos cifrar simplemente la base vectorial?
El cifrado at-rest es necesario, pero resuelve solo una parte.
No resuelve por sí solo consultas autorizadas con scope incorrecto, cross-tenant retrieval, usuarios internos con exceso de privilegios, aplicaciones que devuelven vectores directamente o inversión después de una filtración legítimamente descifrada.
El embedding puede revelar atributos aunque no reconstruya cada palabra
La privacidad no se pierde únicamente cuando recuperamos una frase completa. También puede perderse si podemos inferir características sensibles suficientes.
- temática;
- categorías;
- dominio;
- atributos personales o clínicos;
- presencia de conceptos específicos.
Por eso SPARSE estudia protección orientada a conceptos: no todos los componentes semánticos tienen necesariamente el mismo nivel de sensibilidad.
El pipeline entero debe mantener la clasificación
Supongamos que un documento está clasificado como Restricted. Después lo dividimos en chunks y generamos embeddings.
Sería un error que esos vectores quedaran sin la misma clasificación porque “ya no contienen texto”.
Documento Restricted → chunk Restricted → embedding Restricted → retrieval Restricted.
La sensibilidad debería propagarse con la derivación.
No devolver embeddings al cliente sin necesidad
Muchas aplicaciones no necesitan exponer directamente los vectores generados. Si el frontend solo necesita resultados de búsqueda, devolver embeddings completos aumenta superficie sin aportar valor funcional.
Si una capa no necesita el vector para cumplir su función, no debería recibirlo.
NEURON HUMAN
Cómo diseñaría seguridad de embeddings
1. Clasificarlos como derivados del dato original
Un embedding de información sensible sigue necesitando controles de información sensible.
2. Aislamiento tenant-aware
Filtros de tenant y principal deben ejecutarse como parte del retrieval autorizado.
3. Cifrado y control de acceso
Protección at-rest, in-transit y autorización sobre operaciones de lectura y búsqueda.
4. Reducir exposición directa
No entregar embeddings a clientes o tools que no los necesitan.
5. Procedencia
Cada vector debería poder relacionarse con su documento, chunk, tenant, modelo de embedding y versión.
6. Evaluar ataques de inversión
El threat model debe considerar qué puede inferirse si un atacante obtiene acceso a los vectores.
Qué debería observar un Blue Team
- exportaciones masivas de vectores;
- queries cross-tenant;
- acceso desde servicios nuevos;
- cambios del modelo de embedding;
- vectores sin clasificación o procedencia;
- APIs que exponen embeddings innecesariamente;
- anomalías de consulta orientadas a enumeración.
Qué debería probar un Purple Team
- lectura cross-tenant;
- exportación de embeddings de laboratorio;
- intento de inferir atributos de vectores sintéticos;
- cambio de clasificación durante chunking;
- rotación de modelo y trazabilidad de vectores antiguos;
- revocación de un documento y eliminación de todos sus derivados.
Dónde encaja MindGuard
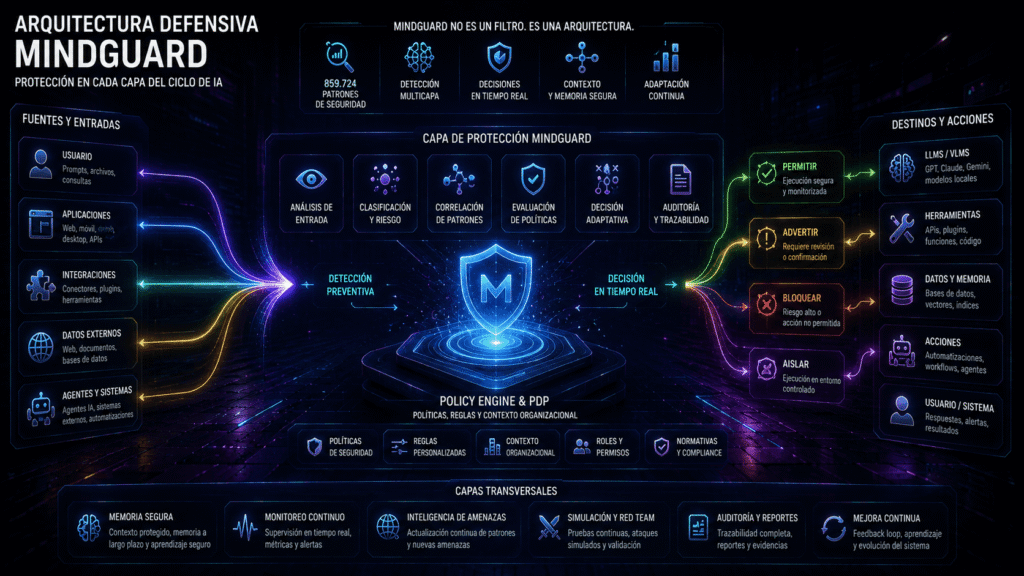
Para MindGuard, un embedding no debería considerarse una representación “limpia” que pierde automáticamente la sensibilidad de su fuente.
La clasificación, el tenant y la procedencia deben acompañar a la derivación.
Transformar un secreto en números no deja de convertirlo en un derivado de un secreto.
MINDGUARD RESEARCH
Los vectores no son invisibles; solo son otra representación
Los embeddings son una de las tecnologías que hacen posible el RAG moderno. Precisamente por eso van a almacenar representaciones de enormes cantidades de información empresarial y personal.
Si no publicarías el documento original, tampoco deberías asumir que su embedding puede publicarse sin riesgo.
NEURON HUMAN
Referencias
- OWASP GenAI — Vector and Embedding Weaknesses
- OWASP GenAI — Data Security Risks & Mitigations 2026
- Kim et al. — Zero2Text (2026)
- Tsai et al. — Concept-Aware Privacy Mechanisms for Defending Embedding Inversion Attacks (2026)
- Tragoudaras et al. — Information Leakage of Sentence Embeddings via Generative Embedding Inversion Attacks
Preguntas frecuentes
¿Los embeddings son datos sensibles?
Pueden serlo cuando derivan de información sensible, porque conservan señales semánticas que pueden permitir inferencias o ataques de inversión.
¿Un embedding es equivalente a un hash?
No. Un embedding está diseñado para conservar relaciones semánticas útiles; un hash criptográfico tiene objetivos de seguridad completamente distintos.
¿El cifrado de la vector database es suficiente?
No. También se necesitan autorización, aislamiento multi-tenant, procedencia, clasificación y controles sobre qué servicios pueden consultar o exportar vectores.